Розробники мобільної операційної системи Android поділилися деякими деталями щодо розпізнавання голосу.
Як з’ясувалося, в основі технології лежать штучні нейронні мережі, які не просто визначають зміст сказаних фраз, але й вчаться з кожним новим розпізнаванням.
Важко повірити, але технології, які вважалися переднім краєм науки в 80-х роках минулого століття, сьогодні стали повсякденною реальністю. За рахунок впровадження нейронних мереж в Android 4.1 розробникам вдалося підвищити точність розпізнавання мови на цілих 25% в порівнянні з попередніми версіями. Ця цифра має і пряме практичне значення – Android-апарати сьогодні насправді пропонують саме точне розпізнавання голосового введення, причому якість весь час зростає.
За революцію в розпізнаванні голосу можна дякувати двох великих дослідників, які проробили величезну роботу (разом з колегами) по створенню унікальної нейромережі на базі обчислювальних ресурсів компанії Google: Вінсента Ванхоука (Vincent Vanhoucke) і Джефа Діна (Jeff Dean). Крім того, теоретичну основу для нинішніх технологій заклав Джеффрі Хінтон (Geoffrey Hinton), професор університету Торонто, коли він зі своєю командою в 2006 р. відкрив спосіб побудови багаторівневих нейромереж, набагато складніших, ніж всі попередники.
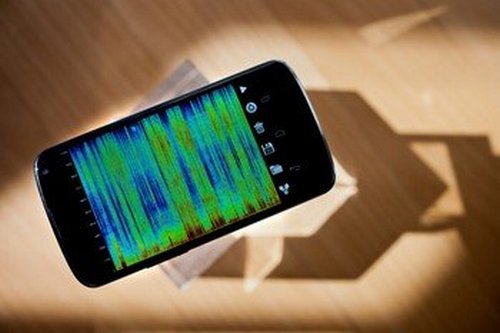
Джефф Дін, вже відомий нашим читачам по створенню системи для розпізнавання кішок на фотографіях, допоміг створити технологію для розподіленої обробки голосового введення: кожне сказане слово користувача перетворюється в спектрограму і відправляється на обробку відразу на вісім різних серверів по всьому світу. Для кожного запиту виконується розпізнавання вихідного мови, виділення голосних і приголосних, а потім – розпізнавання власне слів (разом з навчанням!).
Заслуга Вінсента Ванхоука і його колег полягає в створенні алгоритмічної основи для нейронної мережі – ця мережа дозволяє оцінювати зовсім незнайомі системі зразки, використовуючи тільки знання, отримані раніше з інших зразків. Прорив в нейронних мережах почався в 2006 р. після відкриттів Хінтона і появи недорогих графічних прискорювачів з можливістю виконання завдань загального призначення, а тепер поєднання доступних обчислювальних ресурсів і нових ресурсномістких алгоритмів приводить до швидкого і помітного прогресу в машинному розпізнаванні мови.
Імітація роботи людського мозку стає все більш продуктивною. Крім розробників Android, подібні методи вже використовують фахівці з Microsoft – ми вже писали про створення системи для синхронного перекладу зі збереженням вихідного голосу. Схоже, що численні прогнози футурологів про мовному взаємодії людини і машини нарешті збуваються. Інша справа, що це може призвести до появи систем зразок SkyNet з фільмів про «Термінаторі».